“世界首个多模态世界模型”来了:Atlas 一张图直接炸出 3D 世界
World Labs 发布 Atlas:一张图可继续生成新机位、补全空间、输出 3D,并服务机器人仿真。它把视频、重建与模拟收进同一个空间上下文,但目前仅向少数合作伙伴开放,首创与性能仍主要是官方口径。
一张照片,直接炸成一个能换机位、补空间、输出 3D 的世界。Atlas 这回,真有点疯。
可控视频、空间重建、3D 输出和机器人模拟,Atlas 想把这四件事硬塞进同一个模型。
上面这段 1 分钟演示里,团队给 Atlas 7 张参考图,再手工画一条相机轨迹,镜头就连续穿过同一个场景。官方原帖称完整输出达到 1440p。
9 月 1 日,World Labs 发布 Atlas。官方称它是“世界首个多模态世界模型”,李飞飞也把它看作团队的一次重要里程碑。不过产品目前只向少数合作伙伴提供 early access,还不是一个人人都能打开体验的东西。
这不是普通的“图片动起来”。它真正疯狂的地方,是先把几张平面画面理解成同一个空间,再让相机在这个空间里一路移动。
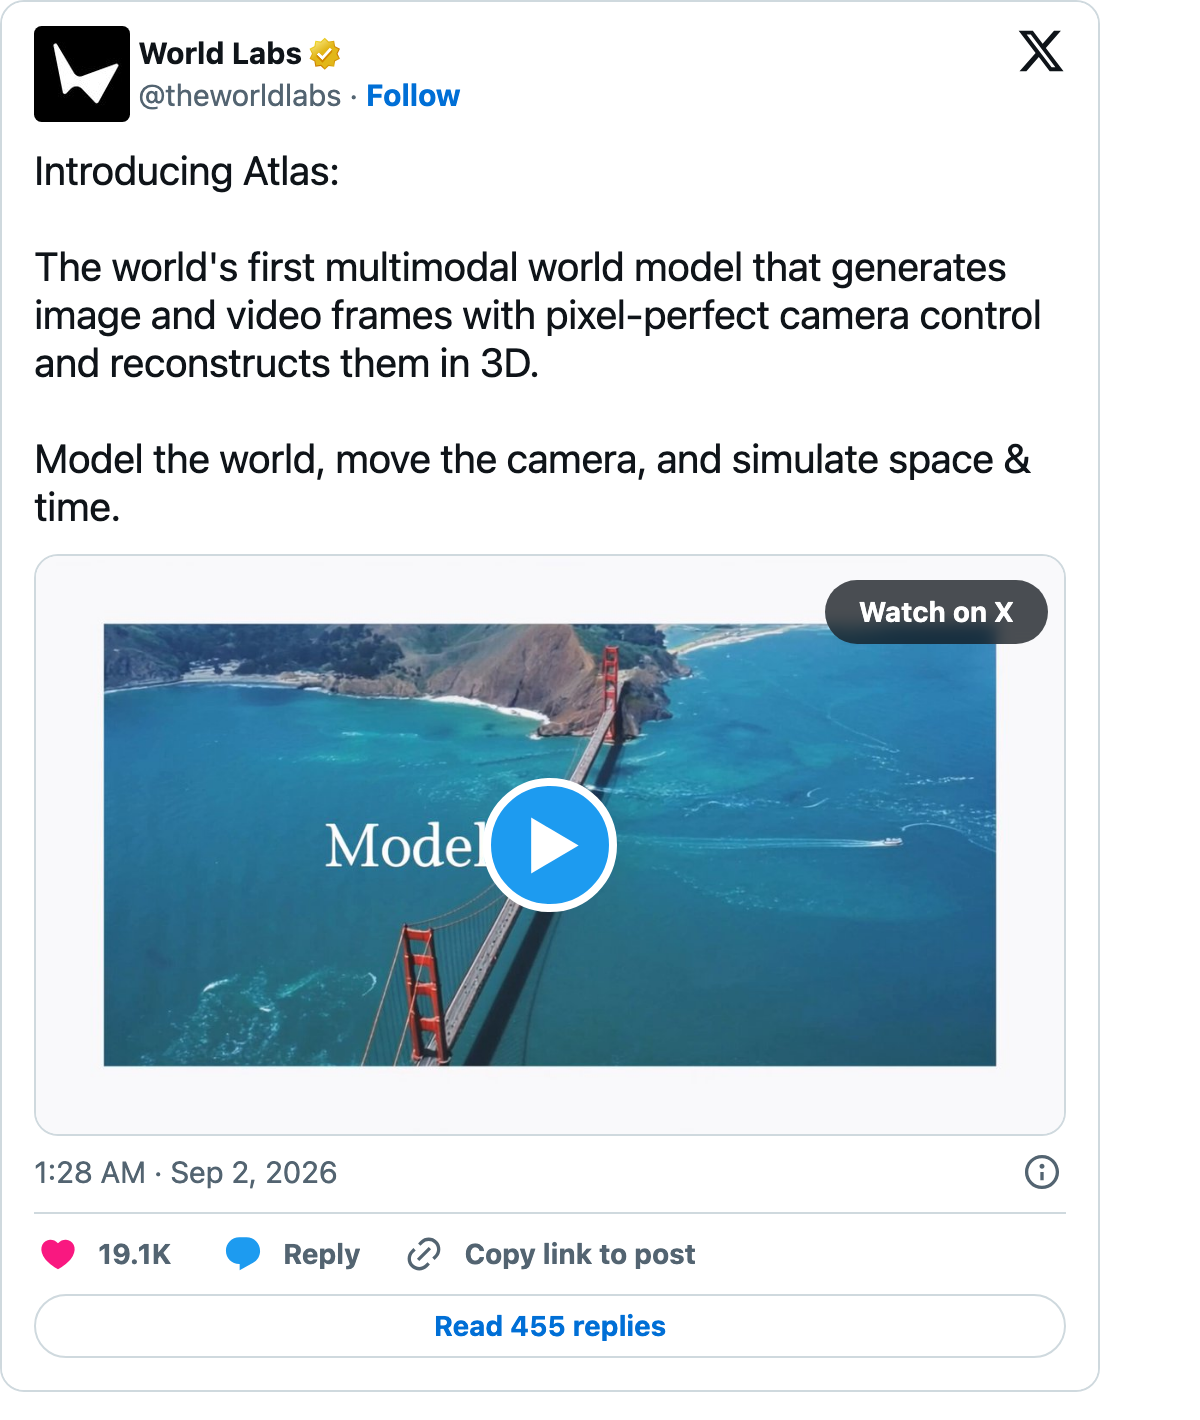
截至 9 月 2 日,World Labs 的首发帖已有约 1.88 万个赞和 451 条回复。热度不低,但生成式影像真正可能被改写的,是基本单位:不再只是一张图或一条视频,而是一个能反复换镜头、继续补全、还可以交给其他工具使用的“世界”。
它和普通视频模型,差在哪儿?
现在大多数 AI 视频工具怎么用,我们已经很熟了:输入提示词或参考图,等模型吐出一段成片。镜头方向不对、人物走位不对,就改提示词,再抽一次。
Atlas 想把这套关系反过来。
World Labs 在发布页里强调,Atlas 会把文本、图像、视频、相机位置和 3D 深度放进同一个“空间上下文”。可以把它想成一个不断扩展的虚拟片场:模型不只记得画面里有什么,还要记得每张图从哪里拍、相机朝向哪里、下一帧该接在空间的哪个位置。
这样一来,相机运动不再只靠一句“向左平移”或“绕人物一圈”的文字要求,而是模型能直接读取的几何输入。官方说得很形象:你是在搭景、调度镜头,不是在拉老虎机拉杆。
视频创作者最先感受到的会是可控性。以前想保住同一场景,往往要在多次生成之间赌一致性;Atlas 的目标,是先保住一个空间,再在里面安排不同机位。
一张图,先变成一条可控镜头
Atlas 能从一张或多张参考图生成新的观察角度,也会把输入画面之外的区域接着补出来。
前面的演示用了 7 张参考图。官网另一处又把一般视频输入写成 1–6 张图,两处数量口径并不一致。稳妥的说法是:它支持用多张参考图共同约束一段长镜头,6 或 7 都不该被当成统一上限。
对广告、短片和预演团队来说,这不只是“视频又长了一点”。它更像把生成模型接进分镜流程:美术先给少量关键画面,导演再设计相机路径,模型负责把中间的世界补齐。
但有一条边界必须先说清楚。
模型补出来的地方,不等于真实世界原本就长这样。World Labs 自己举过例子:给 Atlas 一张泳池边机器人的照片,它会生成机器人的背面,也会猜测泳池旁边可能有草坪。
用于创作,这是想象力;用于测绘、数字孪生或事实还原,它就是误差。
看得越多,想象得越少
Atlas 的第二条路线,是空间重建。
World Labs 称,它能从一张到数十张图片重建真实场景,通常用 2–3 张图就能获得较忠实的结果;如果想尽量还原一个真实地点,空间上下文还能使用超过 100 张图片。
道理并不复杂:输入越少,模型越需要猜;输入越多,它越会被真实画面约束。官方把这句话概括成:“它看得越多,想象得越少。”
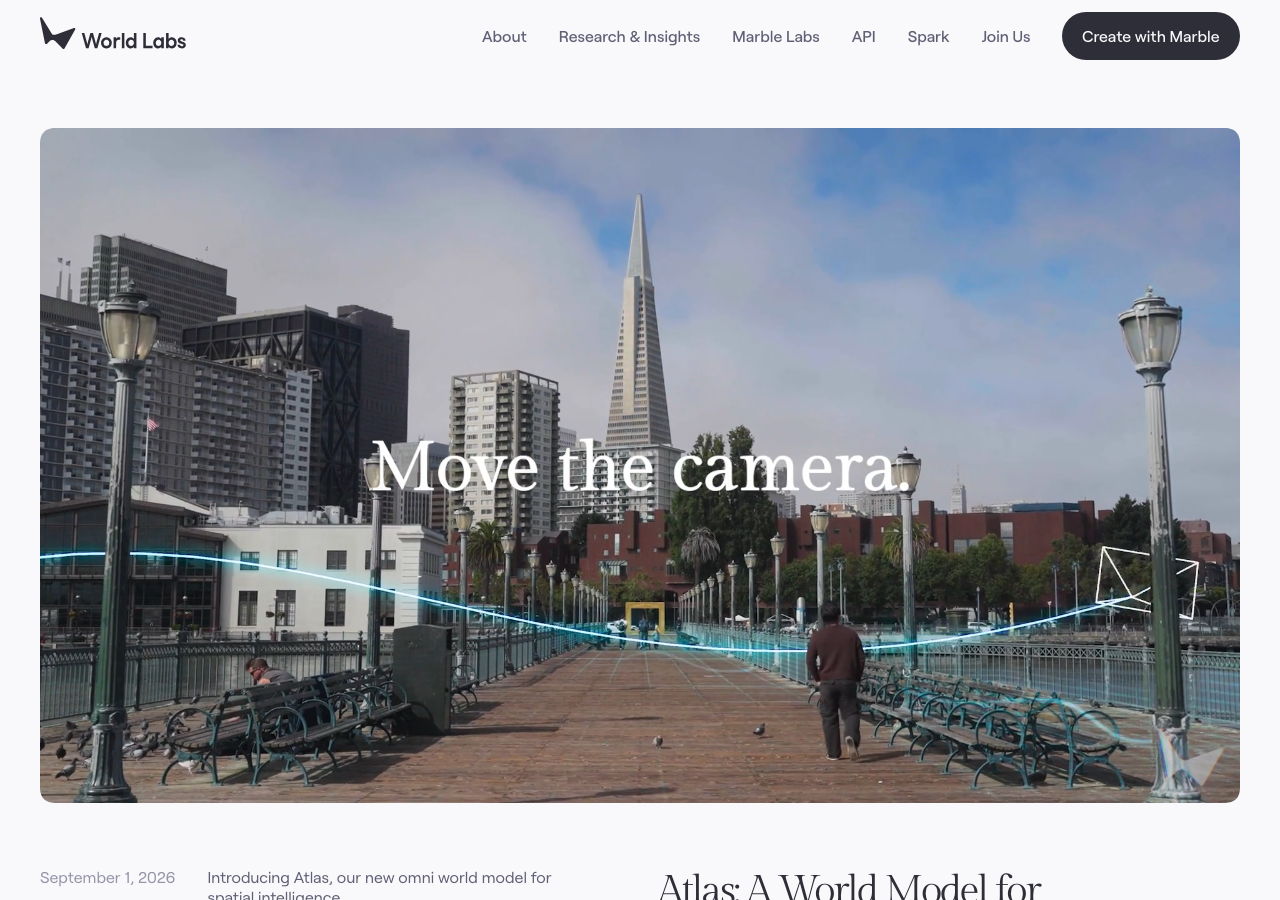
这正是 Atlas 同时像生成模型、又像重建工具的原因。
资料不够时,它依据世界知识补出一个合理空间;资料足够时,它又尽量压低想象,向真实场景靠近。创作者会利用前一种能力拓展画面,3D 和机器人团队则更关心后一种能力能不能稳定、可测量地复现环境。
至于“优于专用 3D 重建模型”的结果,目前仍来自 World Labs 自己的 benchmark 和基线复现。可以关注,不能直接当成已经完成独立验证的行业结论。
输出不只有视频,还有能继续使用的 3D
如果 Atlas 只能生成新镜头,它仍然可以被归进“更可控的视频模型”。真正让它跨进另一套工作流的,是显式 3D 输出。
按官方介绍,Atlas 能输出点云或 3D Gaussian splats。点云可以粗略描述场景几何;Gaussian splat 更像一种能实时渲染的 3D 场景表示,适合把拍到的空间快速变成可以查看、移动和继续处理的资产。
从一张图开始,Atlas 会一起生成新视角和对应几何;从一段真实视频开始,它会预测每帧的深度,再把不同帧组合成 3D 重建。
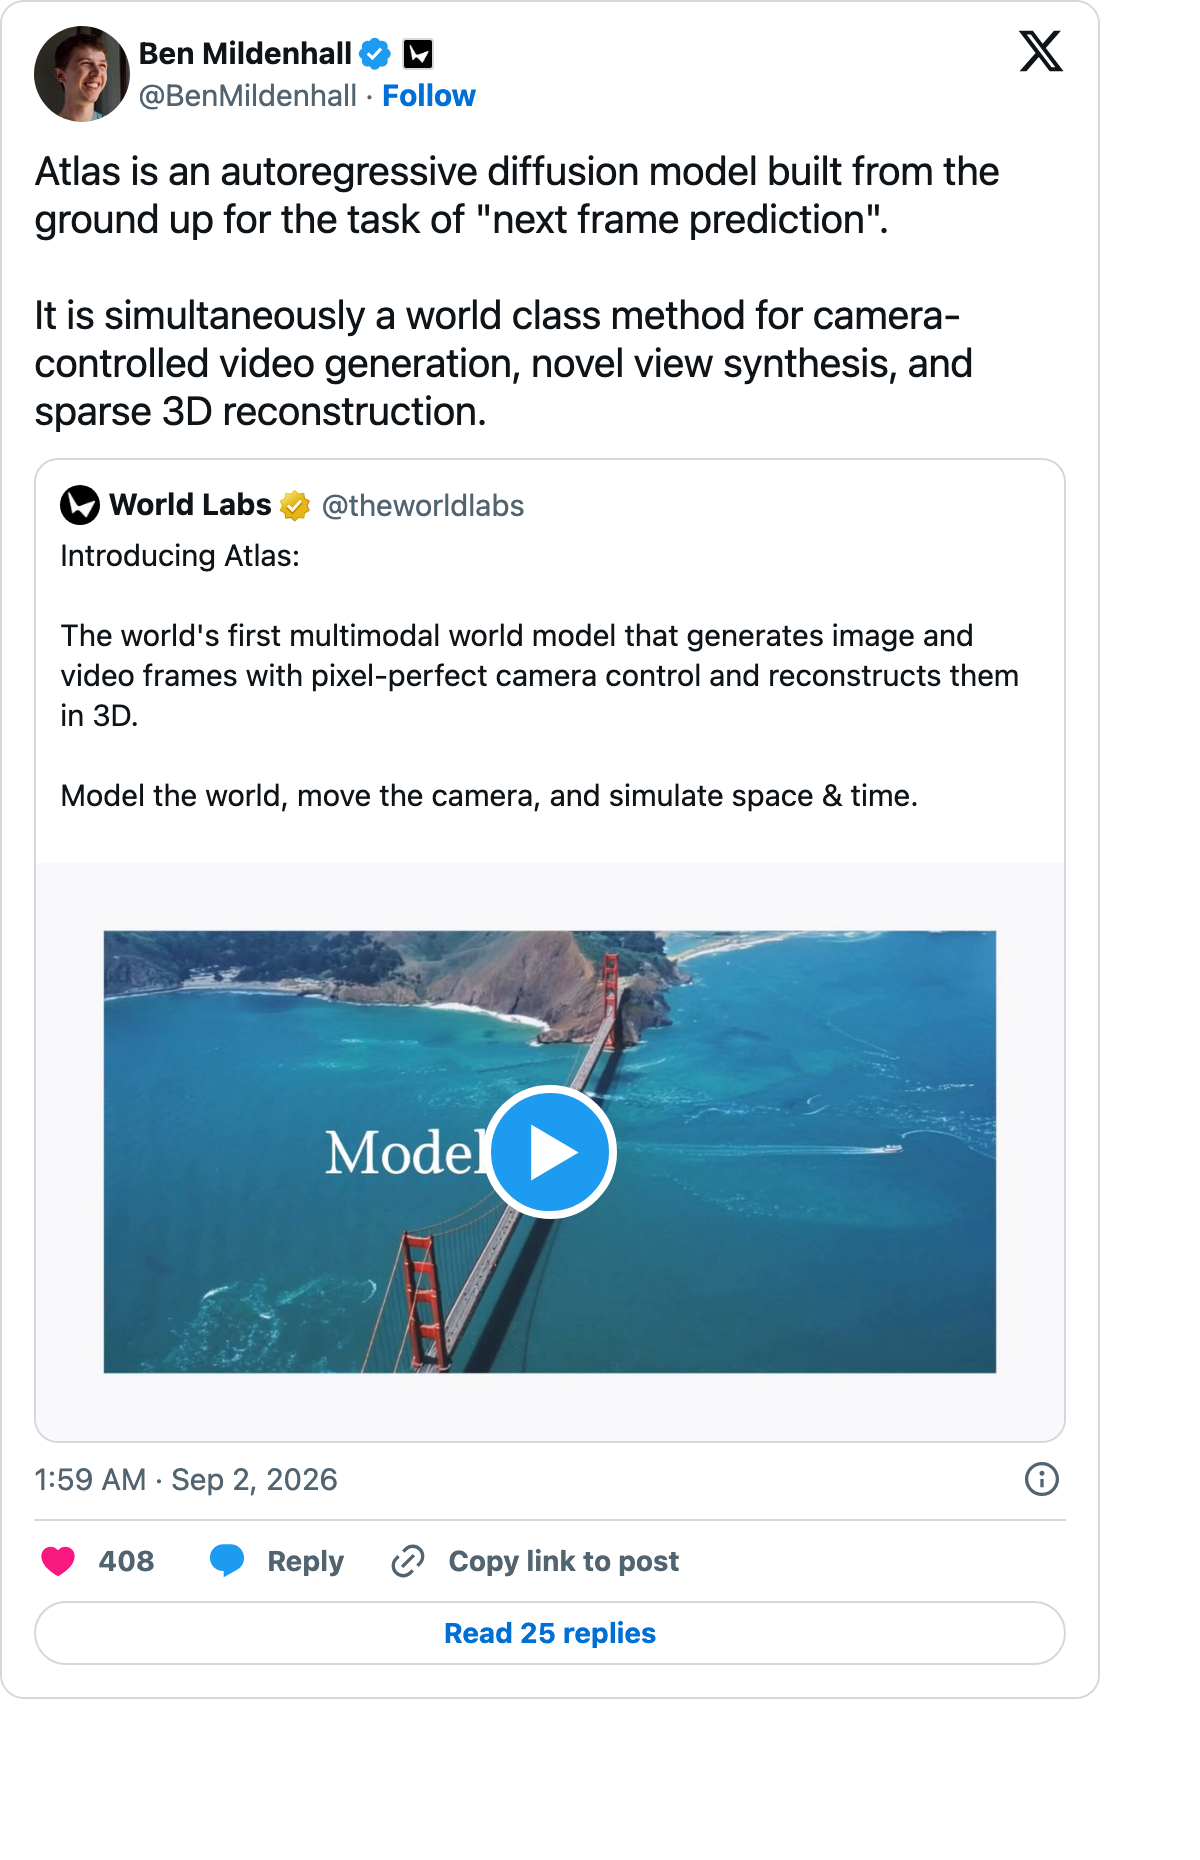
Ben Mildenhall 把 Atlas 解释为一个从头为“下一帧预测”构建的自回归扩散模型。同一套底座同时承担相机可控视频、新视角合成和稀疏 3D 重建,这就是 Atlas 想证明的统一性。
游戏、建筑和 VFX 团队很难不对这件事动心。过去,一张概念图、一条镜头预演和一个可浏览的 3D 场景,往往属于三套流程;Atlas 展示的方向,是让它们从同一个空间状态分叉出去。
当然,“能输出 3D”不等于“直接得到可上线资产”。真实项目仍要处理几何清理、拓扑、材质、碰撞、标定和版权。一个漂亮的 splat 可以很好看,但它与可编辑、可交互、物理正确的生产资产之间,还有距离。
几部手机,也能拍一段“子弹时间”
Atlas 还把空间重建推进到了时间维度。
在官方 bullet time 演示中,团队用 3–5 个普通手机或运动相机拍摄动态瞬间,再重建场景,从原本不存在的机位重新观看。它想替代的不是摄像机,而是一部分昂贵、笨重的多机位采集条件。
如果这条路线能稳定,短片、活动、体育和社交内容会获得一种新的后期自由:拍摄时先拿到足够的空间线索,镜头位置留到后期继续决定。
麻烦也会跟着来。运动速度越快、遮挡越复杂、相机越少,模型需要猜的东西越多。官方演示证明了“可以做”,还没有回答不同场景下的失败率、生成成本和后期修正量。
世界模型为什么会走向机器人
视频和 3D 只是前半段。Atlas 的另一条目标,是给机器人造训练场。
World Labs 在两个大型环境的演示中,先用手机视频采集现场,各取 24 帧完成空间重建,再让 Atlas 生成机器人沿不同路线移动时,机载相机会看到的 RGB 画面和深度数据。
换成人话说:先拍一个真实地点,再把它变成机器人能在里面反复练习的模拟环境。
传统扫描大型空间,设备、时间和现场条件都不轻。Real-to-Sim 的价值,是让团队用更轻量的采集,把更多仓库、办公室、室外路线或操作台带进模拟器。对于物体操作,官方还展示了改变物体、位置、机器人动作、灯光和背景,用来扩充训练与测试情境。
不过,Atlas 并没有因此“替机器人学会行动”。它负责生成环境和传感器观察,机器人如何规划、控制并迁移到真实硬件,仍然是另一层问题。模拟世界越逼真,也越需要警惕那些不容易看见的偏差。
“世界首个”,应该打上引号
World Labs 在首发帖里直接写了“世界首个多模态世界模型”。李飞飞的公开表述稍微克制一些:她称 Atlas 是“first of its kind”,并强调它从头训练。
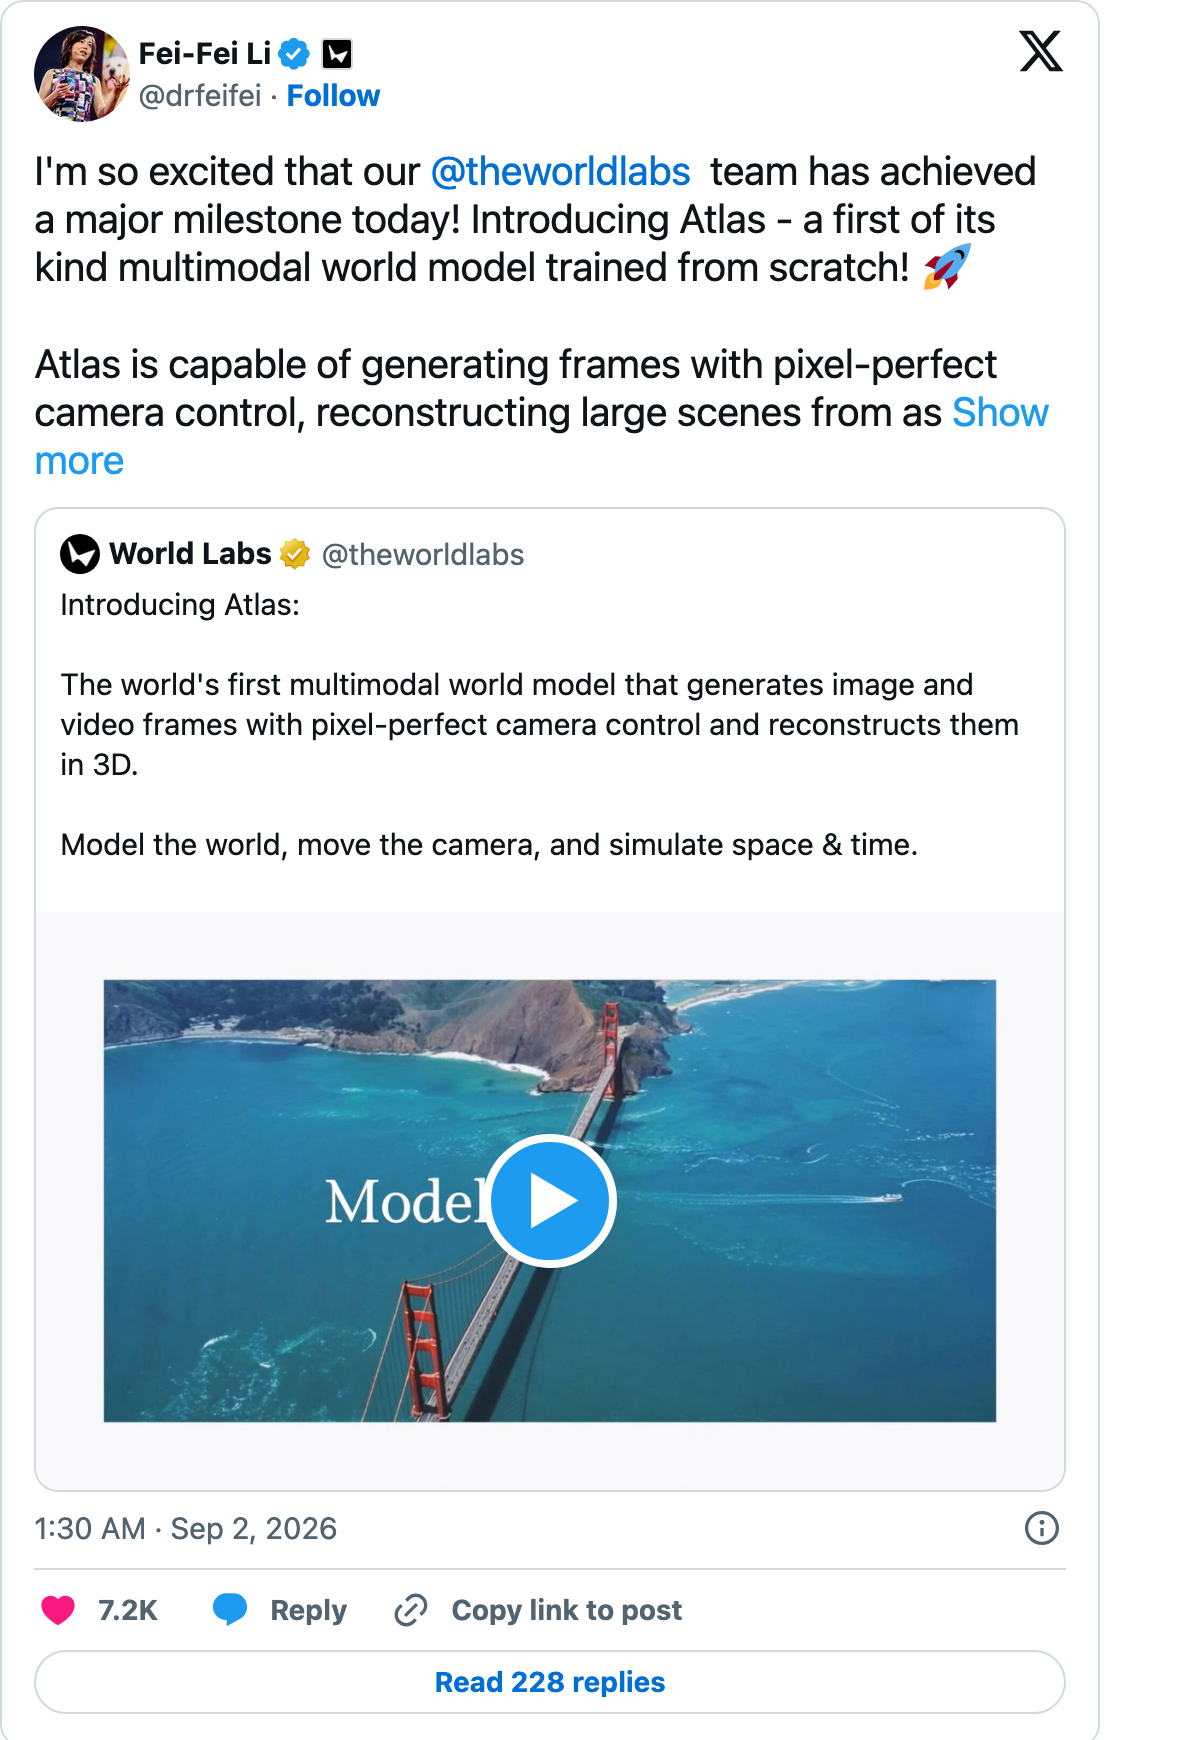
这些都是可靠的一手说法,但仍然是公司和联合创始人的定位,不是独立共识。
Atlas 之前,World Labs 自己已经把多模态世界模型 Marble 向所有用户开放;Google DeepMind 的 Genie 3 主打 720p、24 FPS 的实时可导航世界;NVIDIA Cosmos 则把开放世界基础模型和合成数据放进机器人、自动驾驶的物理 AI 平台。
三条路线解决的重点并不一样。
Genie 3 更像一个能实时进入和探索的生成世界;Cosmos 更像一套训练物理 AI 的基础设施;World Labs 现在想做的,是让创意生成、真实空间重建、显式 3D 和机器人模拟共享一个模型,再由 Atlas 去驱动未来的 Marble 等产品。
Atlas 的“首个”不必替它强行证明。真正值得关注的,是世界模型已经从研究名词,分化成了清楚的产品路线。
真正变化的,可能是创作的基本单位
如果只看发布视频,Atlas 很容易被理解成“一个镜头更听话的视频模型”。
我觉得它释放的更大信号,是创作对象正在改变。
过去,我们让 AI 生成一个文件:一张图、一段视频、一个 3D 模型。Atlas 描绘的工作流,是先生成并维护一个空间状态,再从里面取出不同镜头、不同 3D 表示,甚至不同机器人的训练视角。
对视频和 VFX 团队,它意味着从“反复抽成片”转向“在同一世界里重拍”;对产品经理,它意味着未来的创意工具还要处理版本、权限、空间编辑和多种格式导出;对机器人团队,它意味着真实采集和模拟数据之间可能多出一座更便宜的桥。
现在还不能把这张图画得太满。
Atlas 只向少数合作伙伴开放,价格、公开 API、端到端生成时间、硬件需求和正式开放日期都没有公布。相机控制、重建质量和 benchmark 主要来自厂商页面与演示,外部还没有足够条件做系统复核。
这不是“视频模型已经结束”的故事。它更像一次方向变化:AI 影像正在从生成画面,走向生成一个能被继续操作的空间。
当一张图不再只是成片的起点,而是一个世界的入口,视频、3D、游戏和机器人之间的边界,也会开始变薄。
▪️感谢你的阅读,如果觉得有帮助,随手点个关注、赞👍🏻和推荐♡吧~
▪️这里是 Cyber.阿雷克西,欢迎评论区留言分享你觉得好用的 AI 产品 / 工具~
▪️或许会在不经意间帮助到更多朋友~ 我们下期见~